Trefon.
ls ~/work Projekty

Zbudowane, zmierzone, przekazane.

Silniki open source, które możesz przeczytać linijka po linijce, i projekty dla klientów, które mogę opisać, ale nie nazwać. Każda liczba tutaj pochodzi z benchmarku albo commita, a każde repozytorium jest publiczne.

§01 inferencja

Model 27B, kontekst 262K, jedna karta RTX 4090.

Utrzymuję i rozwijam fork llama.cpp-turboq, silnika, który trzyma 4,125-bitowy cache KV wewnątrz jądra flash attention. To jądro, RotorQuant i pierwsza implementacja MTP to praca upstreamu: Indras-Mirror i współtwórców. Przy cache w FP16 sam kontekst 262K tokenów zająłby dwie trzecie karty 24 GB; z TBQ4 mieści się obok modelu 27B. Moja część to sprawić, żeby to wytrzymywało prawdziwe obciążenia agentowe, codziennie.

Co dodałem

  1. 01 Asynchroniczne zapisywanie checkpointów przez przypięty, dwuslotowy bufor: 32 checkpointy promptu przy prefillu 262K nie blokują już strumienia obliczeń, a przypięta pamięć RAM nie przekracza ~300 MiB zamiast 4,7 GB.
  2. 02 Minimalne dopełnienie cache KV: 16× mniej ponownych przechwyceń grafu CUDA niż przy sztywnym 256 w upstreamie, plus zabezpieczenie ograniczające głębokość szkicu MTP, gdy akceptacja spada poniżej 35%.
  3. 03 Poprawki MTP i Gated DeltaNet pod długie sesje agentowe: synchronizacja kontekstu cienia, stochastyczny sampler szkicu, wycofywanie odrzuceń dla modeli z M-RoPE, bezpiecznik na pętle wywołań narzędzi i ochrona przed dryfem stanu rekurencyjnego przy dużym kontekście.
  4. 04 Połączone jądro chunk pipeline dla prefillu DeltaNet.
  5. 05 Podmiana modelu w locie, w tym samym procesie, bez osobnego routera, oraz rozszerzenia API OpenAI (reasoning effort, przycinanie promptu z uwzględnieniem wiadomości), żeby harnessy agentowe działały bez zmian.
  6. 06 Port cache KV TBQ3 i TBQ4 na Metal z dekwantyzacją w obróconej dziedzinie, żeby ten sam cache działał na Apple silicon.

Zbudowane na: Indras-Mirror/llama.cpp-turboq-mtp ggml-org/llama.cpp

github.com/jtrefon/llama.cpp-turboq-mtp code ↗ → Przeczytaj notatkę
fig. 01 Cache KV przy kontekście 262K
  • FP16 16 GiB
  • tbq4_0 4,1 GiB
  • planar3_0 3,1 GiB
32 768 wartości w cache na token: po 2 bajty w FP16, 66 bajtów na 128 wartości w TBQ4.
fig. 02 Szybkość dekodowania wg kontekstu, tok/s
4K
  • tbq4_0 55,3
  • planar3_0 53,9
32K
  • tbq4_0 51,5
  • planar3_0 50,6
262K
  • tbq4_0 77
  • planar3_0 ~47
RTX 4090, Qwen3.6-27B, włączone MTP i flash attention. Wiersz 262K: konfiguracja pod maksymalną szybkość.
dekodowanie po moim strojeniu produkcyjnym (+31%)
62 → 82tok/s
dekodowanie po moim strojeniu produkcyjnym (+31%)
mniej ponownych przechwyceń grafu CUDA niż w upstreamie
16×
mniej ponownych przechwyceń grafu CUDA niż w upstreamie
przypiętej pamięci na checkpointy zamiast 4,7 GB
≤300MiB
przypiętej pamięci na checkpointy zamiast 4,7 GB
kontekstu obok modelu 27B na 24 GB
262Ktokenów
kontekstu obok modelu 27B na 24 GB

Źródło: README repozytorium i moje commity w forku

§02 harnessy

Harness, który da się zmierzyć.

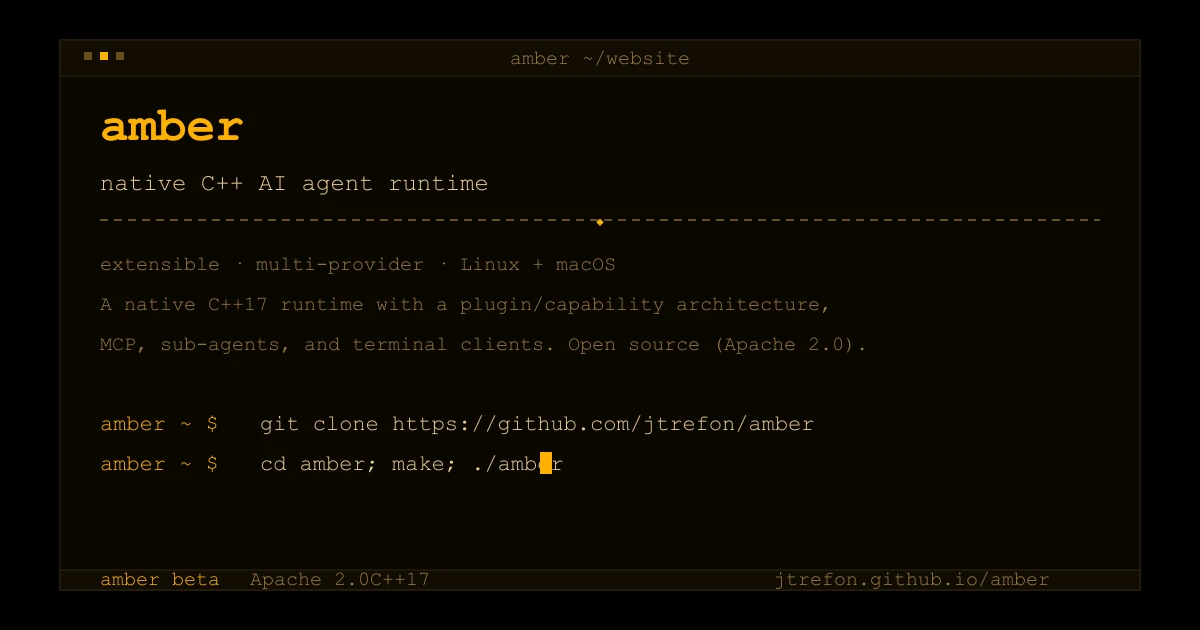
amber to natywne środowisko uruchomieniowe agentów w C++17: jedna architektura wtyczek dla dostawców, narzędzi i UI, wielu dostawców, MCP, subagenci, terminalowy interfejs w stylu BitchX i bezgłowe CLI na Linuksa i macOS. Obok zbudowałem amber-bench, żeby każda zmiana architektury była widoczna jako liczba, a nie przeczucie.
  • 49 scenariuszy w 10 zestawach: kodowanie, praca w terminalu, wybór narzędzi, trzymanie się promptu, refaktoryzacja, code review, delegowanie, błędy agenta i dyscyplina pętli.
  • Każdy scenariusz dostaje 0–100 punktów za poprawność, wydajność, odporność i trzymanie się promptu, ważone trudnością i skalowane do 1000.
  • Skok o 52,5 punktu między v2 a v3 dały trzy błędy harnessu, które wykrył sam benchmark: normalizacja ścieżek w wyroczni, wyciąganie gołego JSON-a i czas życia ujścia SSE.
  • Tryb hermetyczny z udawanym LLM uruchamia zestaw deterministycznie w CI, bez modelu i bez GPU.
amber, native C++ AI agent runtime: git clone github.com/jtrefon/amber; cd amber; make; ./amber
fig. 03 amber-bench, wersje harnessu · Qwopus3.6-27B
  • v2 769,1 · 39/43
  • v3 821,6 · 41/43
Ten sam model, te same scenariusze. Zmienił się tylko harness. Oś 700–1000.
fig. 04 Dziesięć lokalnych modeli, jeden harness · wynik /1000
  • Qwen3.6-27B dense 816,2
  • Qwopus3.6-27B-v2-MTP 808,0
  • Gemma-4-31B 806,2
  • Gemma-4-12B Q4 780,0
  • Ornith-1.0-35B 770,0
  • Qwen3.6-27B MTP 768,8
  • Gemma-4-12B Q8 756,8
  • Qwen3.6-35B-A3B MoE 742,2
  • Qwen3.6-27B pi-reason. 723,3
  • Ornith-1.0-9B 716,6
Po 49 scenariuszy, sekwencyjnie, jeden slot GPU. Oś 700–1000.
§03 desktop

Natywne IDE na macOS. Bez Electrona.

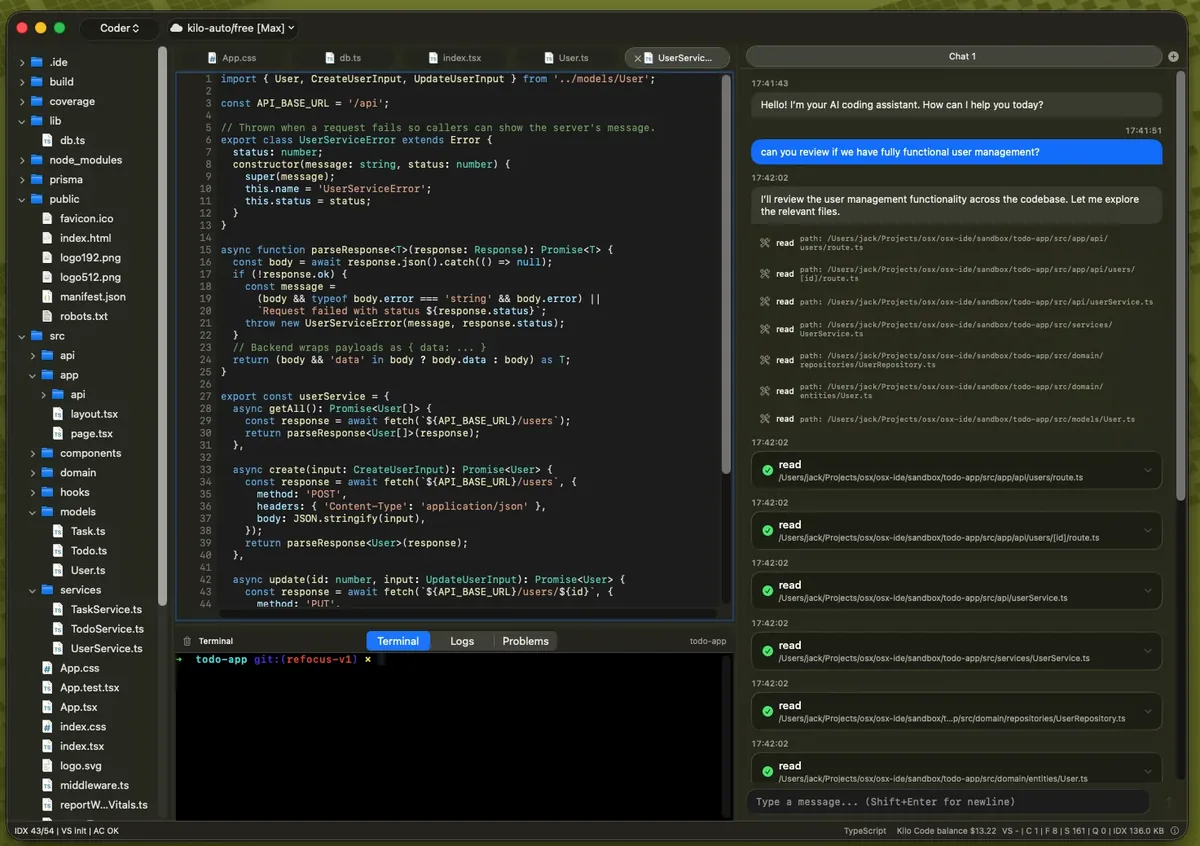
IDE compass: drzewo plików, edytor kodu z serwisem w TypeScript, terminal i czat agenta czytający pliki projektu
fig. 05 — compass, czat agenta przeglądający projekt w TypeScript

compass to IDE z AI napisane w Swifcie. Kodowanie agentowe działa na Twoim dostawcy i Twoich kluczach; RAG po Twoim kodzie, uzupełnianie fill-in-the-middle i czat działają na urządzeniu, także offline. Licencja MIT, instalacja przez Homebrew.

  • Swift
  • RAG na urządzeniu
  • uzupełnianie FIM
  • czat offline
  • własne klucze
  • MIT
§05 projekty dla klientów

Projekty dla klientów: opisane, nie nazwane.

To, co buduję, należy do klientów, więc ich nazw tu nie ma. Architekturę mogę Ci pokazać na rozmowie.

  1. Harness przekazane

    Nieruchomości off-plan, Dubaj

    Agentowa platforma sprzedażowa: rdzeń i API w .NET, back office w Angularze, agent czatowy w React, wielu dostawców LLM przez OpenRouter.

    • .NET
    • Angular
    • React
    • OpenRouter
  2. Harness przekazane

    Agenci sprzedaży przychodzącej, kilka rynków

    Agenci napisani w PHP i wdrożeni wewnątrz aplikacji klienta, podpięci pod lokalne skrypty, procedury i wiedzę domenową, działający na Gemini API. Szybcy, tani i niezawodni.

    • PHP
    • Gemini API
  3. Modele w toku · NDA

    Ekstrakcja dokumentów, klient z branży księgowej (sektor regulowany)

    Pipeline ekstrakcji oparty na modelu wizyjnym. W toku, objęty NDA.

    • model wizyjny
    • Python
  4. Modele w treningu

    Model compass (w toku, open source)

    Agentowy model do kodowania 4,5B: Qwen dostrojony do pracy w terminalu i jako agent, potem destylowany i dostrajany przez RL pod konkretne języki i stosy, trenowany na jednej karcie RTX 4090, dołączany do compass.

    • Qwen
    • RL
    • destylacja
    • RTX 4090

Masz taki problem?

Opisz swój problem

30-minutowa rozmowa techniczna z inżynierem, który to buduje. Bez działu sprzedaży, bez slajdów.